运维手册香港高防秒解服务器的常见配置与优化实践
本文为面向工程师的操作指南,概述了在香港机房部署高防秒解服务器时需要关注的选型要点、网络与系统层面的调优、常见安全策略与监控报警,以及实践中容易忽视的细节,便于快速建立稳定可恢复的运维流程。
在选择香港节点时,优先考虑网络连通性与骨干带宽,建议评估上游带宽、AS路径以及是否支持多线BGP。对于需要抗DDoS的场景,优先选择提供商具备专有清洗能力与秒解服务的机房,确认是否有云清洗+硬件防护双层策略。选型时对比带宽峰值计费、突发流量保底、和清洗响应SLA。
启用硬件或云端清洗能在链路层过滤大流量攻击,避免业务实例被耗尽资源。验证方法包括脚本化压力测试(弱流量到大流量分阶段)、观察清洗触发日志和丢包率、以及要求厂商提供真实攻击演练报告。确认厂商支持的攻击类型(SYN/UDP/HTTP Flood、CC等)与清洗阈值。
为应对高并发连接与短连接场景,应调整TCP与netfilter相关内核参数,例如 net.core.somaxconn、net.ipv4.tcp_fin_timeout、net.ipv4.tcp_tw_reuse、net.netfilter.nf_conntrack_max、net.ipv4.tcp_max_syn_backlog 等。目的是减少TIME_WAIT占用、提升半连接队列长度与conntrack上限,防止连接耗尽导致服务不可用。
在iptables/nftables上设定分层规则:第一层白名单(管理IP/监控),第二层限速与连接聚合(SYN速率限制、conntrack阈值)、第三层基于geo/ipset的黑名单。配合fail2ban或自定义脚本实现基于失败次数的动态封禁,同时保留审计日志以便回溯。避免全局DROP策略导致监控/集群间心跳误判。
在Nginx/HTTP层应调整worker_processes/worker_connections、keepalive_timeout、client_body_buffer_size、sendfile与tcp_nodelay等,开启gzip与静态资源缓存或使用CDN分流。对API接口实施限流(漏桶/令牌桶),在应用层做幂等设计和短路熔断,使用缓存(Redis/Memcached)减少后端数据库压力。
监控覆盖网络(丢包、延迟、带宽)、系统(CPU、内存、磁盘IO、conntrack)、应用(响应时延、QPS、错误率)与清洗(触发次数、被拦截流量)。建议使用Prometheus+Grafana或Zabbix,并在机房侧与业务侧双向埋点,设置多层告警:阈值告警、速率突变告警与清洗事件告警,并保证告警走多渠道。
日志应采用本地落盘+远程异地同步(如对象存储或集中日志平台),并对写入做流控避免磁盘吞吐被耗尽。重要配置文件与密钥做定期加密备份,备份存储应位于不同网络域或云存储,保证在机房受影响时仍可恢复并进行故障排查。
自动化能在攻击或故障时快速响应,降低人为失误。建议用Ansible/Terraform管理配置与部署,把常用恢复步骤(如替换路由、切换清洗策略、重载服务)脚本化,并在每次变更前做灰度验证。保持Runbook(操作手册)版本化,确保值班人员能按照流程快速执行。
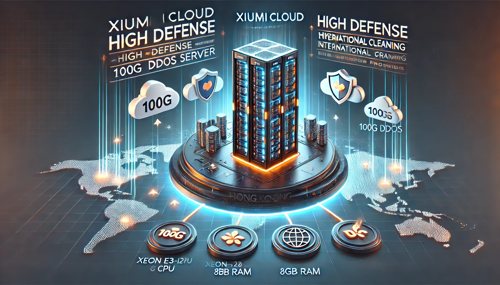
常见被忽视项包括默认管理端口暴露、弱口令、SSH密钥未集中管理、服务信息泄露(版本指纹)。建议关闭不必要服务、使用跳板机+MFA、限制管理网段、对外接口做WAF规则以及对API进行签名校验。定期做漏洞扫描与演练,确保补丁与规则及时落地。
在事件结束后进行复盘:收集流量与日志、还原攻防时间线、评估清洗效果与SLA达成情况、识别薄弱环节并制定整改项。用量化指标(业务可用率、恢复时间MTTR、误判率)评估改善效果,并把复盘结果反馈到监控、报警与自动化脚本中,形成闭环改进。
-
香港购买高防手表指南
香港购买高防手表指南 香港是一个聚集了各种国际品牌手表的购物天堂。从经典的瑞士手表到日本的高科技手表,香港拥有丰富的选择。无论您是钟情于传统机械表还是追求时尚科技的智能手表,香港都能满足您的需求。 在香港购买高防手表有许多优势。首先,香港有着成熟的购物环境和完善的售后服务,能够保障您的购物体验。其次,香港的手表价格相对较低,可2025年6月8日 -
香港100g高防服务器费用优惠促销
香港100g高防服务器费用优惠促销 近日,香港100g高防服务器推出了一项费用优惠促销活动,为用户提供更优惠的价格和更稳定的服务。这一活动旨在帮助用户降低成本,提升在线业务的安全性和稳定性。 香港100g高防服务器具有以下特点: 高防护能力:拥有强大的防御能力,可以有效抵御各种DDoS攻击,保障服务器和网站的安全。 高性能:服2025年5月19日 -

香港高硬防服务器的性能与安全性全面评测
在当今数字化时代,对服务器的性能和安全性要求不断提升。本文将对香港高硬防服务器进行全面评测,从性能、抗攻击能力、安全性等多个维度深入分析,帮助用户更好地理解这一产品的优势与适用场景。 香港高硬防服务器的性能表现如何? 在选择服务器时,性能是一个至关重要的因素。香港高硬防服务器通常配备高性能的处理器、大容量内存及快速的硬盘存储。这些硬件配置使得2025年12月2日 -
香港VPS CN2高防服务器:提供稳定、高效的网络保护方案
香港VPS CN2高防服务器:提供稳定、高效的网络保护方案 随着互联网的迅猛发展,网络安全问题日益突出。为了保护企业和个人的网络安全,提高网站的稳定性和访问速度,香港VPS CN2高防服务器应运而生。本文将详细介绍香港VPS CN2高防服务器的特点和优势。 香港VPS CN2高防服务器是一种基于虚拟化技术的服务器,它结合了CN2025年4月5日 -
香港高防服务器机构:最佳网络安全解决方案
香港高防服务器机构:最佳网络安全解决方案 随着互联网的迅速发展,网络安全问题日益凸显。特别是在香港这样的国际金融中心,网络安全已经成为企业和个人不可忽视的重要问题。在这种情况下,香港高防服务器机构成为了最佳的网络安全解决方案。 高防服务器是一种针对DDoS攻击进行优化的服务器,它具有强大的网络防2025年1月25日 -
高防服务器:香港PCCW提供的最佳选择
高防服务器:香港PCCW提供的最佳选择 高防服务器是一种能够抵御各种网络攻击和恶意行为的服务器。它拥有强大的防护能力,能够保护您的网站、应用程序和数据免受DDoS攻击、黑客入侵、恶意软件等威胁。 香港PCCW是全球领先的通信服务提供商之一,拥有丰富的经验和先进的技术,为客户提供可靠的网络服务。以下是选择香港PCCW的高防服务器的2025年1月25日 -
香港高防服务器渠道选择指南
香港高防服务器渠道选择指南 随着互联网的快速发展,网络安全问题变得越来越重要。对于在香港运营的企业来说,选择一家可靠的高防服务器渠道是确保网络安全的关键。本指南将为您介绍如何选择适合您需求的高防服务器渠道。 当选择香港高防服务器渠道时,有几个关键因素需要考虑: 带宽和网络稳定性:确保渠道提供足够的带宽和稳定的网络连接。 DD2025年1月25日 -
香港高防电话号码:最可靠的网络安全解决方案
香港高防电话号码:最可靠的网络安全解决方案 高防电话号码是一种专门为保护企业网络安全而设计的服务。它通过提供高强度的防御机制,帮助企业抵御各种网络攻击,包括DDoS攻击、网络钓鱼等。 1. 强大的防御能力:高防电话号码能够快速识别并阻止各种网络攻击,保护企业网络安全。 2. 高效的应对措施:一旦发现异常流量,高防电话号码会立即2025年6月28日 -
最佳香港高防服务器供应商推荐
最佳香港高防服务器供应商推荐 在当今数字化时代,对于企业来说,拥有一台稳定可靠的高防服务器至关重要。特别是对于位于香港的企业来说,选择一家信誉良好的高防服务器供应商至关重要。本文将介绍一些最佳的香港高防服务器供应商。 ABC高防服务器是一家在香港拥有良好口碑的供应商。他们提供24/7的技术支持,确保您的服务器始终稳定运行。AB2025年7月5日